Desempenho · método e números
Até 200 Gbps por equipamento, com os recursos ativados.
Números que você pode reproduzir, não arredondar para cima. Os benchmarks de destaque neste mercado costumam ser executados com tamanhos de pacote grandes, com os recursos de assinante desabilitados e com pouco do método divulgado. A Netavo declara o seu método, apresenta os números em IMIX com QoS e CGNAT habilitados, e entrega a mesma versão para que você possa reproduzi-los no seu próprio hardware.
Base declarada. Cada número traz a CPU, a NIC, o perfil de tráfego e a contagem de sessões com que foi produzido, e indica se é uma medição em bancada de testes ou derivado do benchmark por pacote. Nenhum número de destaque sem a sua base ao lado.
IMIX ao lado de cada número de pacotes grandes. Um resultado a 1500 bytes, sozinho, superestima a capacidade real. Os dois números, bidirecionais.
Recursos ativados. Os números de destaque pressupõem QoS e CGNAT habilitados em plena escala de sessões, a configuração que você operaria. O encaminhamento sem recursos aparece apenas como linha secundária.
Reproduzível. O mesmo benchmark por commit que produz estes números está na versão de avaliação. Execute-o no seu próprio hardware e confira-os.
Para calibração: a afirmação de vazão por servidor mais destacada deste mercado — um terabit — foi produzida com pacotes de 1.024 bytes em um teste de laboratório de marca conjunta. Resultados desse tipo são prática padrão do setor, e são o motivo pelo qual as operadoras descontam os benchmarks dos fornecedores.
Preferimos publicar um número que você possa reproduzir a um número maior que você não possa. Cada número da tabela abaixo declara a sua base e atende às regras R1–R4.
| Hardware de referência | Assinantes | Vazão, nos dois sentidos | Taxa de pacotes em IMIX | QoS + CGNAT | Núcleos do plano de dados |
|---|---|---|---|---|---|
| entrada · 8 núcleos / 2×10G | 5.000 | taxa de linha — 20 Gbps | 13 Mpps | habilitado | ~1 encaminhamento · ~3 com CGNAT |
| intermediária · 16 núcleos / 2×25G | 25.000 | taxa de linha — 50 Gbps | 33 Mpps | habilitado | ~3 encaminhamento · ~6 com CGNAT |
| alta · 32 núcleos / 2×100G | 100.000 | taxa de linha — 200 Gbps | 131 Mpps | habilitado | ~9 encaminhamento · ~24 com CGNAT |
Tanto o tráfego IMIX quanto o de 1500 bytes atingem a taxa de linha da interface em todas as configurações acima: o custo por pacote do pipeline deixa folga de taxa de pacotes em IMIX, de modo que o limite é a interface, não a CPU. As contagens de núcleos são derivadas do benchmark por commit do pipeline em x86-64 — 31–55 ns/pacote para encaminhamento e 46–178 ns/pacote para CGNAT com conjuntos de trabalho de 50k sessões e 1M de fluxos — nas taxas de pacotes da taxa de linha em IMIX (quadro médio de ≈362 bytes), com margem para a sobrecarga da NIC e do driver; os números de CGNAT pressupõem todos os assinantes traduzidos. Reproduza-os com o benchmark incluído na versão de avaliação. Quer ver a sua classe de hardware representada? Conte-nos o que você usa.
Os mesmos contadores que o protocolo de benchmark registra — visíveis ao vivo em qualquer implantação, incluindo a versão de avaliação.
Plataforma · Hardware compatível
Roda nos servidores que você já compra.
O Netavo BNG é implantado em servidores x86-64 padrão — Intel Xeon ou AMD EPYC — com dois caminhos de E/S de pacotes: um caminho DPDK para desempenho máximo em adaptadores de rede validados, e um caminho de compatibilidade que funciona em praticamente qualquer adaptador, incluindo máquinas virtuais. O mesmo software e a mesma configuração nos dois caminhos.
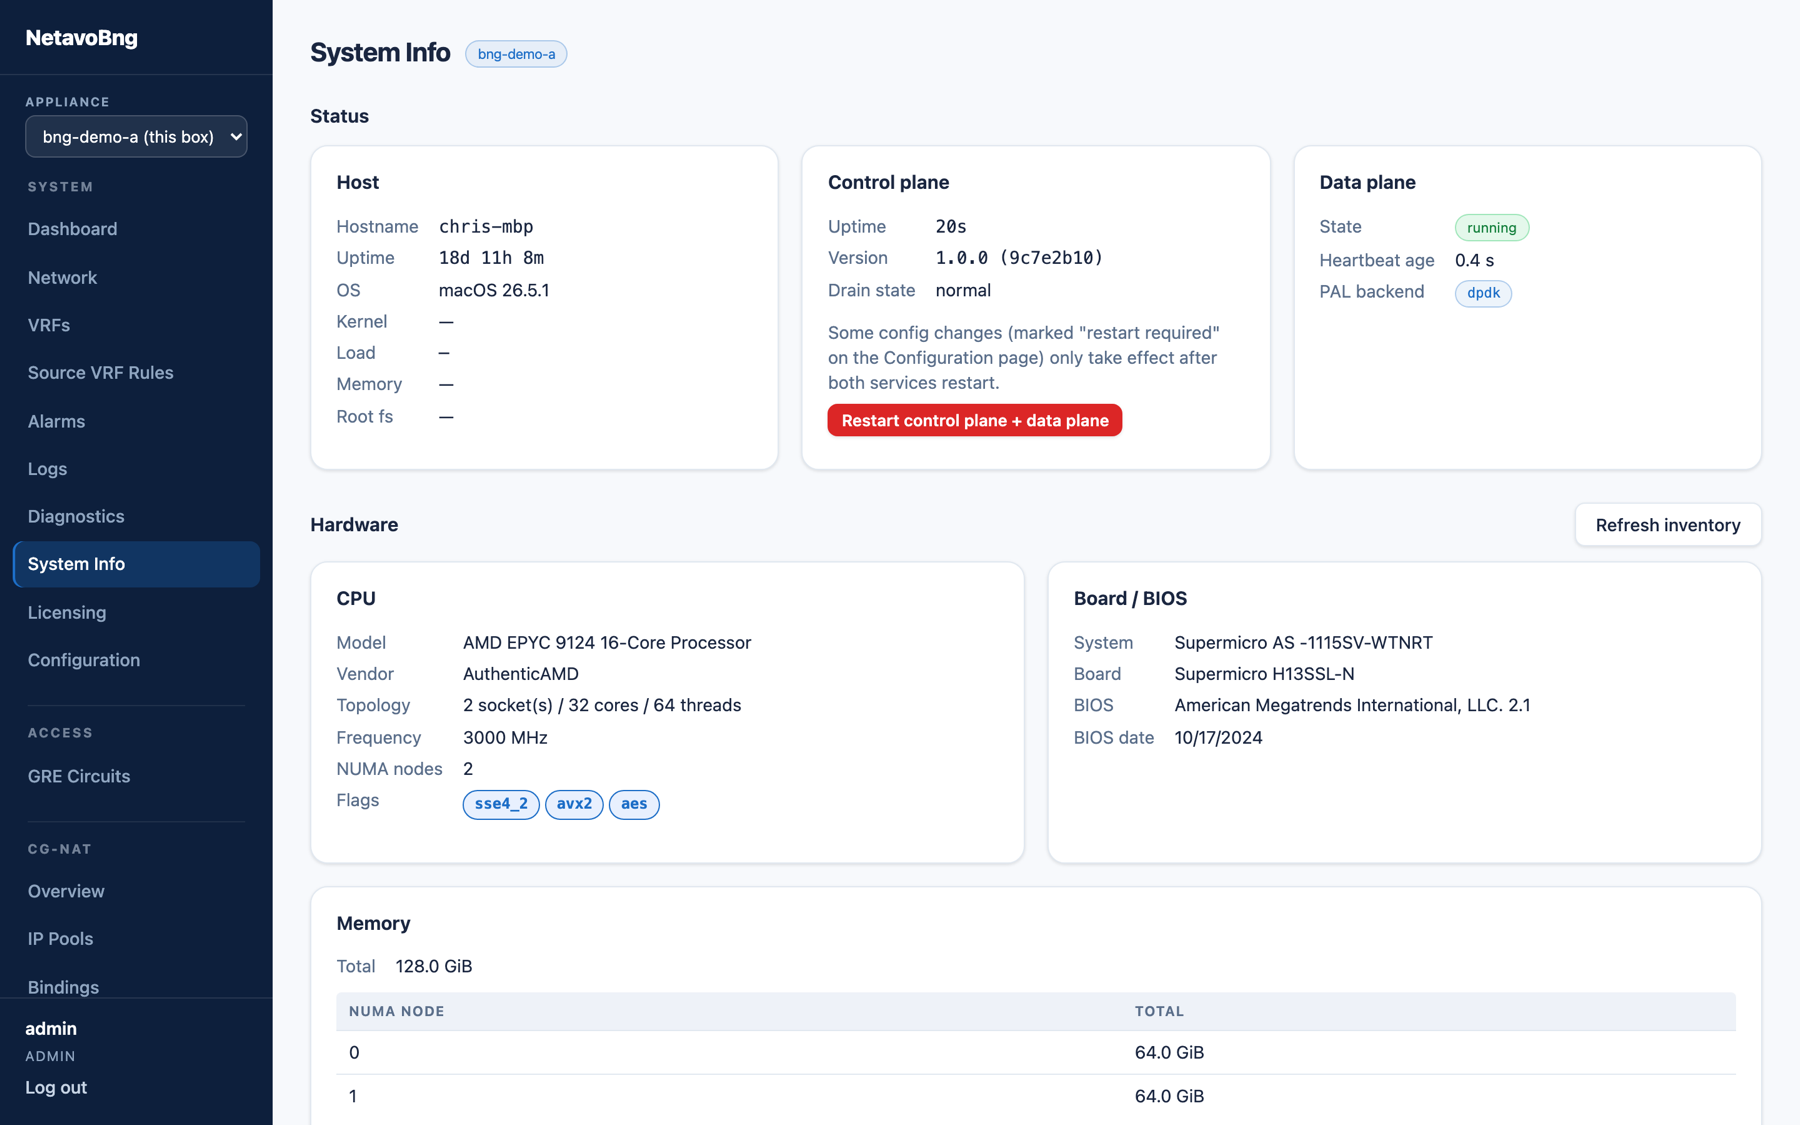
O equipamento informa o seu próprio inventário — CPU, memória, NICs e o caminho de E/S ativo do plano de dados.
Caminho de desempenho — DPDK
E/S em modo de polling com bypass do kernel em adaptadores validados, com núcleos dedicados ao plano de dados e memória hugepage. O caminho para implantações de produção a 10G e acima.
NICs validadas · IOMMU/VT-d · hugepages
Caminho de compatibilidade — AF_XDP
E/S de alto desempenho pelo kernel em praticamente qualquer adaptador, com operação zero-copy nas famílias compatíveis. O caminho para laboratórios, avaliações, sites pequenos e funções em máquina virtual — não exige nenhuma configuração especial de BIOS.
Qualquer NIC de servidor padrão · zero-copy nas famílias compatíveis
O equipamento informa o seu próprio inventário — CPU, memória, adaptadores e o caminho de E/S ativo.
Qualquer processador x86-64 moderno. As implantações de produção rodam em plataformas de servidor — Intel Xeon ou AMD EPYC — nas quais a memória ECC, o número de vias PCIe e as opções de NIC se ajustam à função. Não há licenciamento por núcleo, portanto o número de núcleos é uma escolha puramente de engenharia.
Processadores de desktop (Intel Core, AMD Ryzen) rodam o software de forma idêntica e são adequados para laboratórios, avaliações e sites pequenos; para produção, recomendamos plataformas de servidor pela memória ECC e pela confiabilidade da plataforma, e não por algum requisito do software.
Os workers do plano de dados escalam com os núcleos: a orientação de dimensionamento acompanha o protocolo de benchmark, incluindo uma curva de escala por núcleo, para que o hardware não listado possa ser dimensionado por cálculo, e não por suposição.
| Caminho de desempenho | Caminho de compatibilidade | |
|---|---|---|
| CPU | x86-64 · 8+ núcleos recomendados | x86-64 · 4+ núcleos |
| Memória | 32 GB+ · hugepages reservadas | 8–16 GB · hugepages opcionais |
| Firmware | VT-d / IOMMU habilitado | configurações padrão |
| Armazenamento | SSD · 100 GB+ | SSD · 50 GB+ |
| Família de adaptadores | Caminho | Observações |
|---|---|---|
| Intel série 700 (X710 / XL710) | DPDK — desempenho | 10G / 40G · o caminho de produção validado, em serviço na nossa própria rede |
| Intel série 800 (E810) | DPDK ou AF_XDP zero-copy | 25G / 100G · no DPDK com o pacote DDP da Intel, PPPoE e L2TP são distribuídos por hardware |
| Intel série 500 (X520/X550) | AF_XDP zero-copy | 10G · fácil de encontrar no mercado de usados, adequada para avaliações |
| NVIDIA ConnectX (mlx5) | AF_XDP zero-copy | 25G+ |
| Adaptadores comuns (1G/2.5G) | AF_XDP em modo de cópia | laboratórios e sites pequenos · sem configuração especial |
| virtio (máquina virtual) | AF_XDP | Implantações em máquina virtual — veja abaixo |
A lista de hardware validado é publicada a cada versão e cresce com o programa de benchmark; a telemetria das implantações (apenas inventário de hardware agregado) nos indica quais plataformas validar em seguida.
Funções menores rodam como máquina virtual no caminho de compatibilidade — a função L2TP LNS é totalmente compatível com uma máquina virtual comum, reutilizando o plano de controle completo, sem uma compilação separada. Avaliações e laboratórios costumam começar assim antes de migrar para bare metal.
Bare metal no caminho DPDK continua sendo a recomendação sempre que a vazão máxima importa: o protocolo de benchmark da página de desempenho se aplica a bare metal, e os números publicados indicarão a plataforma explicitamente.
Uma função LNS de produção em uma máquina virtual — software e configuração idênticos aos de bare metal.
Faça o benchmark no seu próprio hardware.
A versão de avaliação é a versão de produção. Implante-a no seu próprio hardware x86, submeta-a ao seu gerador de tráfego e compare os seus resultados com os nossos.