Rendimiento · método y cifras
Hasta 200 Gbps por equipo, con las funciones activadas.
Cifras que puede reproducir, no redondear al alza. Las pruebas de rendimiento que encabezan los titulares de este mercado suelen ejecutarse con tamaños de paquete grandes, con las funciones de abonado deshabilitadas y revelando poco del método. Netavo declara su método, da sus cifras con IMIX y con QoS y CGNAT habilitados, y entrega la misma versión para que pueda reproducirlas en su propio hardware.
Base declarada. Cada cifra lleva la CPU, la NIC, el perfil de tráfico y el número de sesiones con los que se obtuvo, e indica si es una medición en banco de pruebas o se deriva de la prueba de rendimiento por paquete. Ninguna cifra de titular sin su base al lado.
IMIX junto a cada cifra de paquetes grandes. Un resultado a 1500 bytes por sí solo sobrestima la capacidad real. Ambas cifras, bidireccionales.
Funciones activadas. Las cifras de titular suponen QoS y CGNAT habilitados a plena escala de sesiones, la configuración con la que usted operaría. El reenvío sin funciones aparece solo como línea secundaria.
Reproducible. La misma prueba de rendimiento por commit que produce estas cifras está en la versión de evaluación. Ejecútela en su propio hardware y compruébelas.
Como referencia: la afirmación de caudal por servidor más destacada de este mercado — un terabit — se obtuvo con paquetes de 1.024 bytes en una prueba de laboratorio de marca compartida. Los resultados de ese tipo son práctica habitual en el sector, y son la razón por la que los operadores descuentan las pruebas de rendimiento de los fabricantes.
Preferimos publicar una cifra que usted pueda reproducir antes que una mayor que no pueda. Cada cifra de la tabla siguiente declara su base y cumple las reglas R1–R4.
| Hardware de referencia | Abonados | Caudal, en ambos sentidos | Tasa de paquetes con IMIX | QoS + CGNAT | Núcleos del plano de datos |
|---|---|---|---|---|---|
| entrada · 8 núcleos / 2×10G | 5.000 | velocidad de línea — 20 Gbps | 13 Mpps | habilitado | ~1 reenvío · ~3 con CGNAT |
| media · 16 núcleos / 2×25G | 25.000 | velocidad de línea — 50 Gbps | 33 Mpps | habilitado | ~3 reenvío · ~6 con CGNAT |
| alta · 32 núcleos / 2×100G | 100.000 | velocidad de línea — 200 Gbps | 131 Mpps | habilitado | ~9 reenvío · ~24 con CGNAT |
Tanto el tráfico IMIX como el de 1500 bytes alcanzan la velocidad de línea de la interfaz en todas las configuraciones anteriores: el coste por paquete del pipeline deja margen de tasa de paquetes con IMIX, de modo que el límite es la interfaz, no la CPU. Los recuentos de núcleos se derivan de la prueba de rendimiento por commit del pipeline en x86-64 — 31–55 ns/paquete para el reenvío y 46–178 ns/paquete para CGNAT con conjuntos de trabajo de 50k sesiones y 1M de flujos — a las tasas de paquetes de la velocidad de línea con IMIX (trama media de ≈362 bytes), con margen para la sobrecarga de la NIC y del controlador; las cifras de CGNAT suponen que todos los abonados están traducidos. Reprodúzcalas con la prueba de rendimiento incluida en la versión de evaluación. ¿Quiere ver representada su clase de hardware? Cuéntenos qué utiliza.
Los mismos contadores que registra el protocolo de pruebas de rendimiento — visibles en vivo en cualquier despliegue, incluida la versión de evaluación.
Plataforma · Hardware compatible
Funciona en los servidores que usted ya compra.
Netavo BNG se despliega en servidores x86-64 estándar — Intel Xeon o AMD EPYC — con dos rutas de E/S de paquetes: una ruta DPDK para el máximo rendimiento en adaptadores de red validados, y una ruta de compatibilidad que funciona en prácticamente cualquier adaptador, incluidas las máquinas virtuales. El mismo software y la misma configuración en ambas rutas.
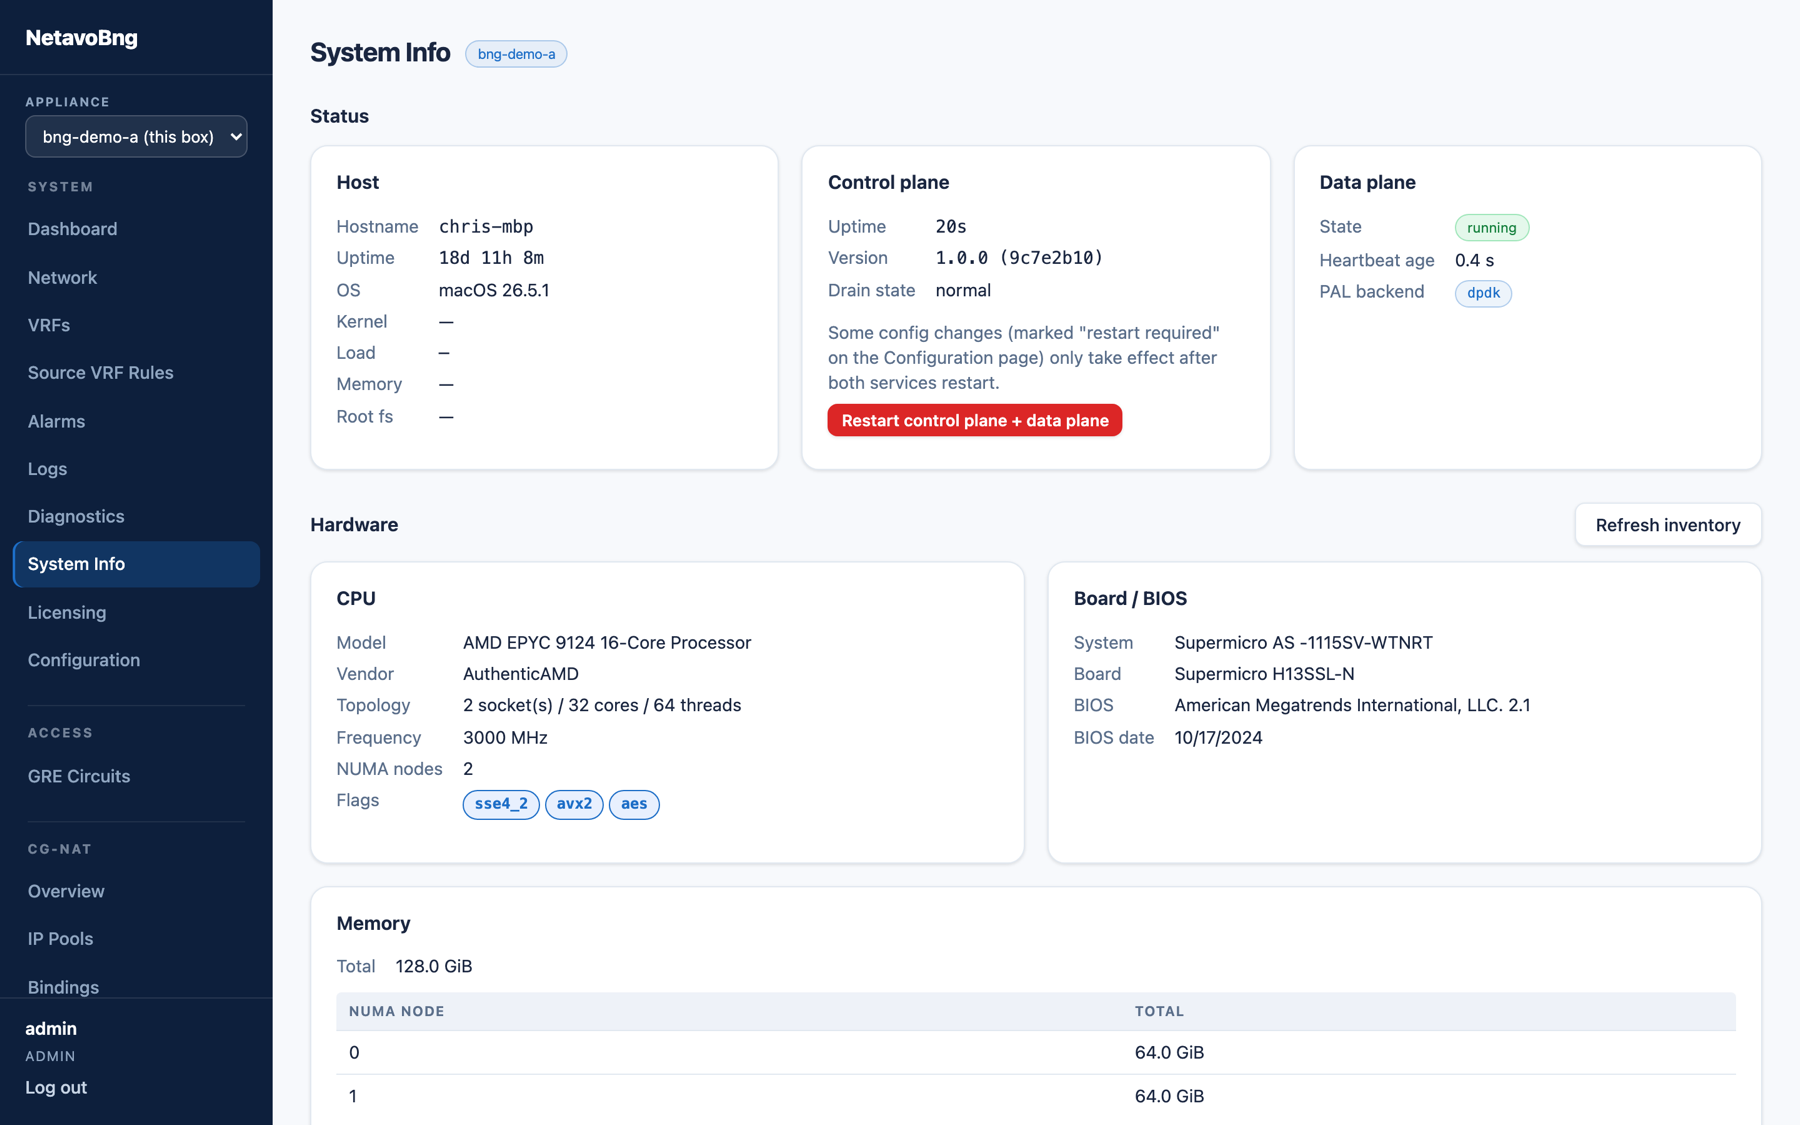
El equipo informa de su propio inventario — CPU, memoria, NIC y la ruta de E/S activa del plano de datos.
Ruta de rendimiento — DPDK
E/S en modo de sondeo con omisión del kernel en adaptadores validados, con núcleos dedicados al plano de datos y memoria hugepage. La ruta para despliegues de producción a 10G y superiores.
NIC validadas · IOMMU/VT-d · hugepages
Ruta de compatibilidad — AF_XDP
E/S de alto rendimiento a través del kernel en prácticamente cualquier adaptador, con funcionamiento zero-copy en las familias compatibles. La ruta para laboratorios, evaluaciones, sitios pequeños y roles en máquina virtual — no requiere ninguna configuración especial de la BIOS.
Cualquier NIC de servidor estándar · zero-copy en las familias compatibles
El equipo informa de su propio inventario — CPU, memoria, adaptadores y la ruta de E/S activa.
Cualquier procesador x86-64 moderno. Los despliegues de producción se ejecutan en plataformas de servidor — Intel Xeon o AMD EPYC — donde la memoria ECC, el número de líneas PCIe y las opciones de NIC se ajustan al rol. No hay licencia por núcleo, de modo que el número de núcleos es una decisión puramente de ingeniería.
Los procesadores de escritorio (Intel Core, AMD Ryzen) ejecutan el software de forma idéntica y son adecuados para laboratorios, evaluaciones y sitios pequeños; para producción recomendamos plataformas de servidor por la memoria ECC y la fiabilidad de la plataforma, no por ningún requisito del software.
Los workers del plano de datos escalan con los núcleos: la guía de dimensionamiento se entrega con el protocolo de pruebas de rendimiento, incluida una curva de escalado por núcleo para que el hardware no listado pueda dimensionarse mediante cálculo y no por conjeturas.
| Ruta de rendimiento | Ruta de compatibilidad | |
|---|---|---|
| CPU | x86-64 · 8+ núcleos recomendados | x86-64 · 4+ núcleos |
| Memoria | 32 GB+ · hugepages reservadas | 8–16 GB · hugepages opcionales |
| Firmware | VT-d / IOMMU habilitado | ajustes estándar |
| Almacenamiento | SSD · 100 GB+ | SSD · 50 GB+ |
| Familia de adaptadores | Ruta | Notas |
|---|---|---|
| Intel serie 700 (X710 / XL710) | DPDK — rendimiento | 10G / 40G · la ruta de producción validada, en servicio en nuestra propia red |
| Intel serie 800 (E810) | DPDK o AF_XDP zero-copy | 25G / 100G · en DPDK con el paquete DDP de Intel, PPPoE y L2TP se distribuyen por hardware |
| Intel serie 500 (X520/X550) | AF_XDP zero-copy | 10G · fácil de encontrar de segunda mano, adecuada para evaluaciones |
| NVIDIA ConnectX (mlx5) | AF_XDP zero-copy | 25G+ |
| Adaptadores genéricos (1G/2.5G) | AF_XDP en modo copia | laboratorios y sitios pequeños · sin configuración especial |
| virtio (máquina virtual) | AF_XDP | Despliegues en máquina virtual — véase más abajo |
La lista de hardware validado se publica con cada versión y crece con el programa de pruebas de rendimiento; la telemetría de los despliegues (solo inventario de hardware agregado) nos indica qué plataformas validar a continuación.
Los roles más pequeños se ejecutan como máquina virtual en la ruta de compatibilidad — el rol L2TP LNS es totalmente compatible con una máquina virtual convencional, y reutiliza el plano de control completo sin una compilación aparte. Las evaluaciones y los laboratorios suelen empezar así antes de pasar a bare metal.
Bare metal en la ruta DPDK sigue siendo la recomendación allí donde importa el caudal máximo: el protocolo de pruebas de rendimiento de la página de rendimiento se aplica a bare metal, y las cifras publicadas indicarán la plataforma de forma explícita.
Un rol LNS de producción en una máquina virtual — software y configuración idénticos a los de bare metal.
Mida el rendimiento en su propio hardware.
La versión de evaluación es la versión de producción. Despliéguela en su propio hardware x86, sométala a su generador de tráfico y compare sus resultados con los nuestros.